
0mniGen人物一致性解决新方案,AI图像编辑神器提供零基础上手指南。
电脑配置要求:win10/11系统
16G以上内存于:推荐32G以上
N卡(英伟达显卡)8G以上显存推荐12G以上显存
OmniGen简介
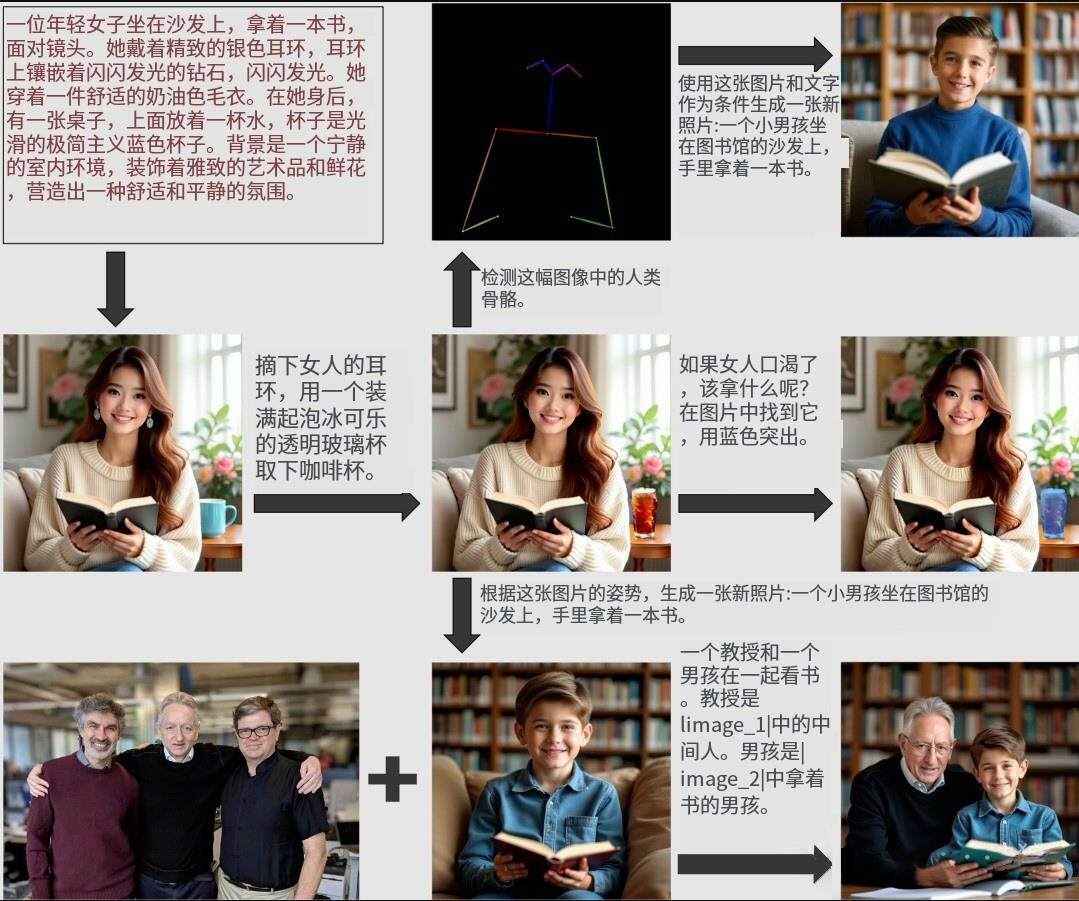
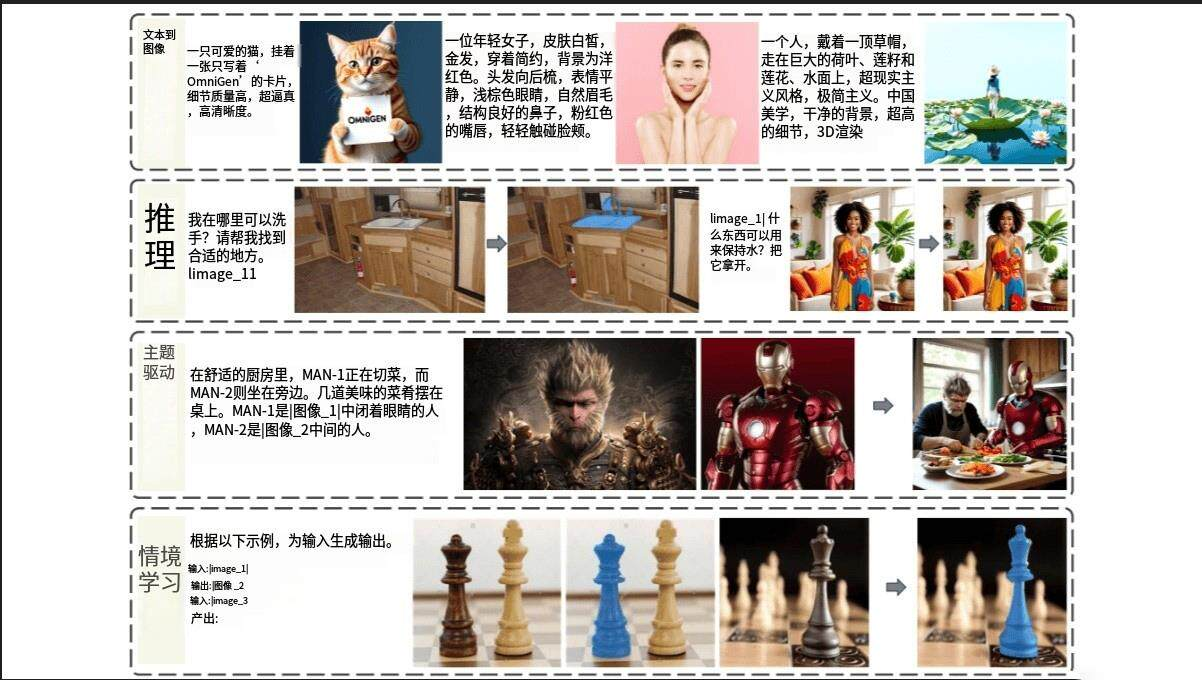
今天文章主题为一款由北京人工智能研究原提出的统一图像框架:OmniGen。OmniGen是一个统一的图像生成扩散模型,将多种图像处理任务集成到一个统一的简化框架中。与传统的扩散模型不同,OmniCen无需额外的模块如ControlNet或IP-Adapter即可处理多样化的控制条件。OmniGen的特点包括:
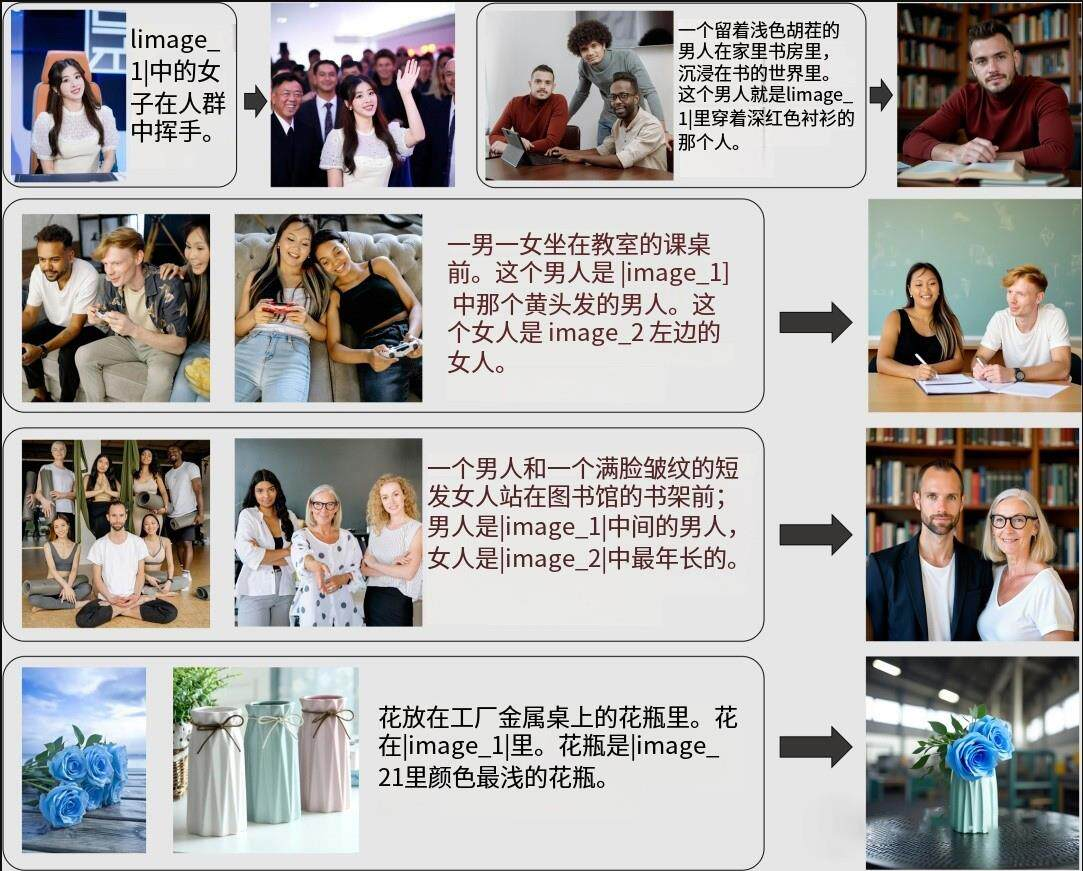
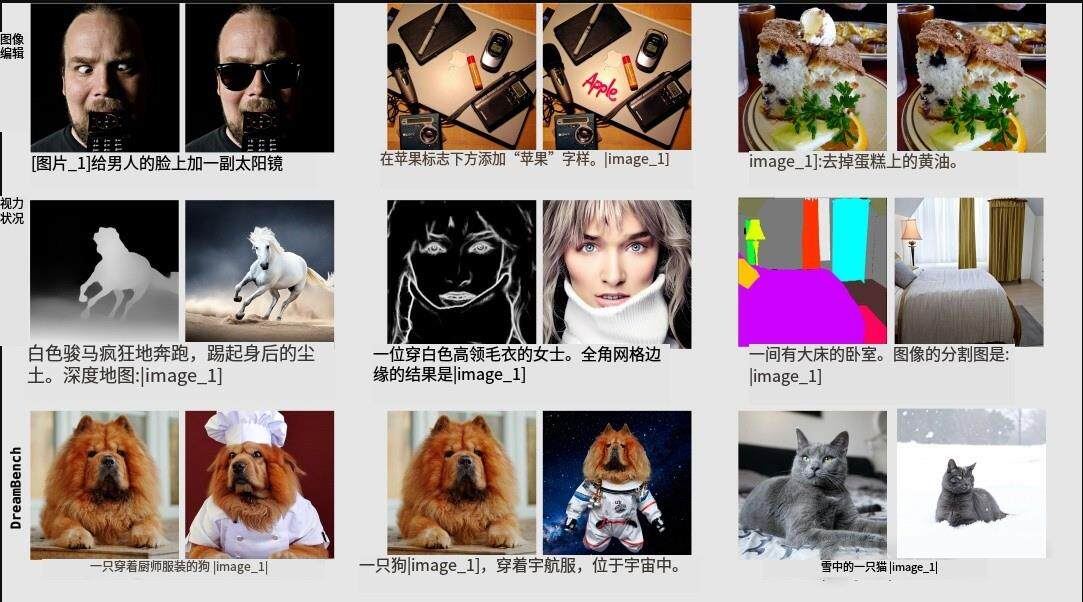
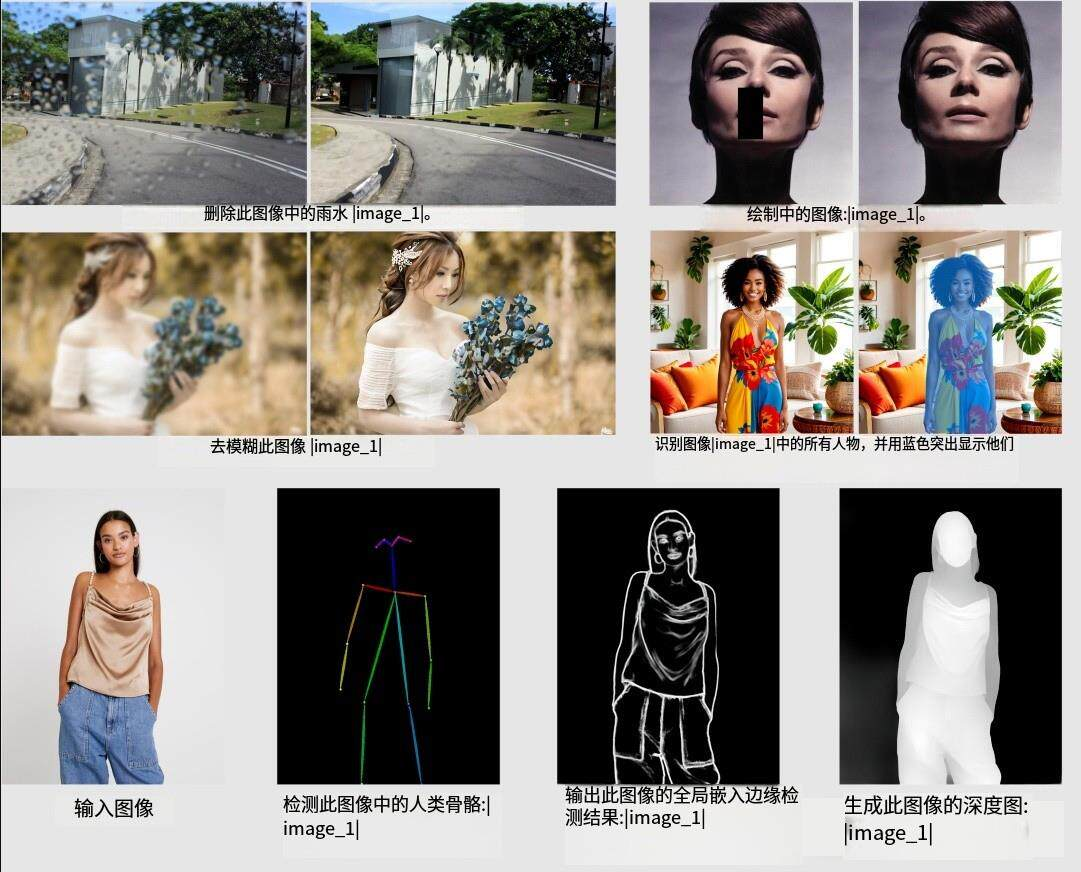
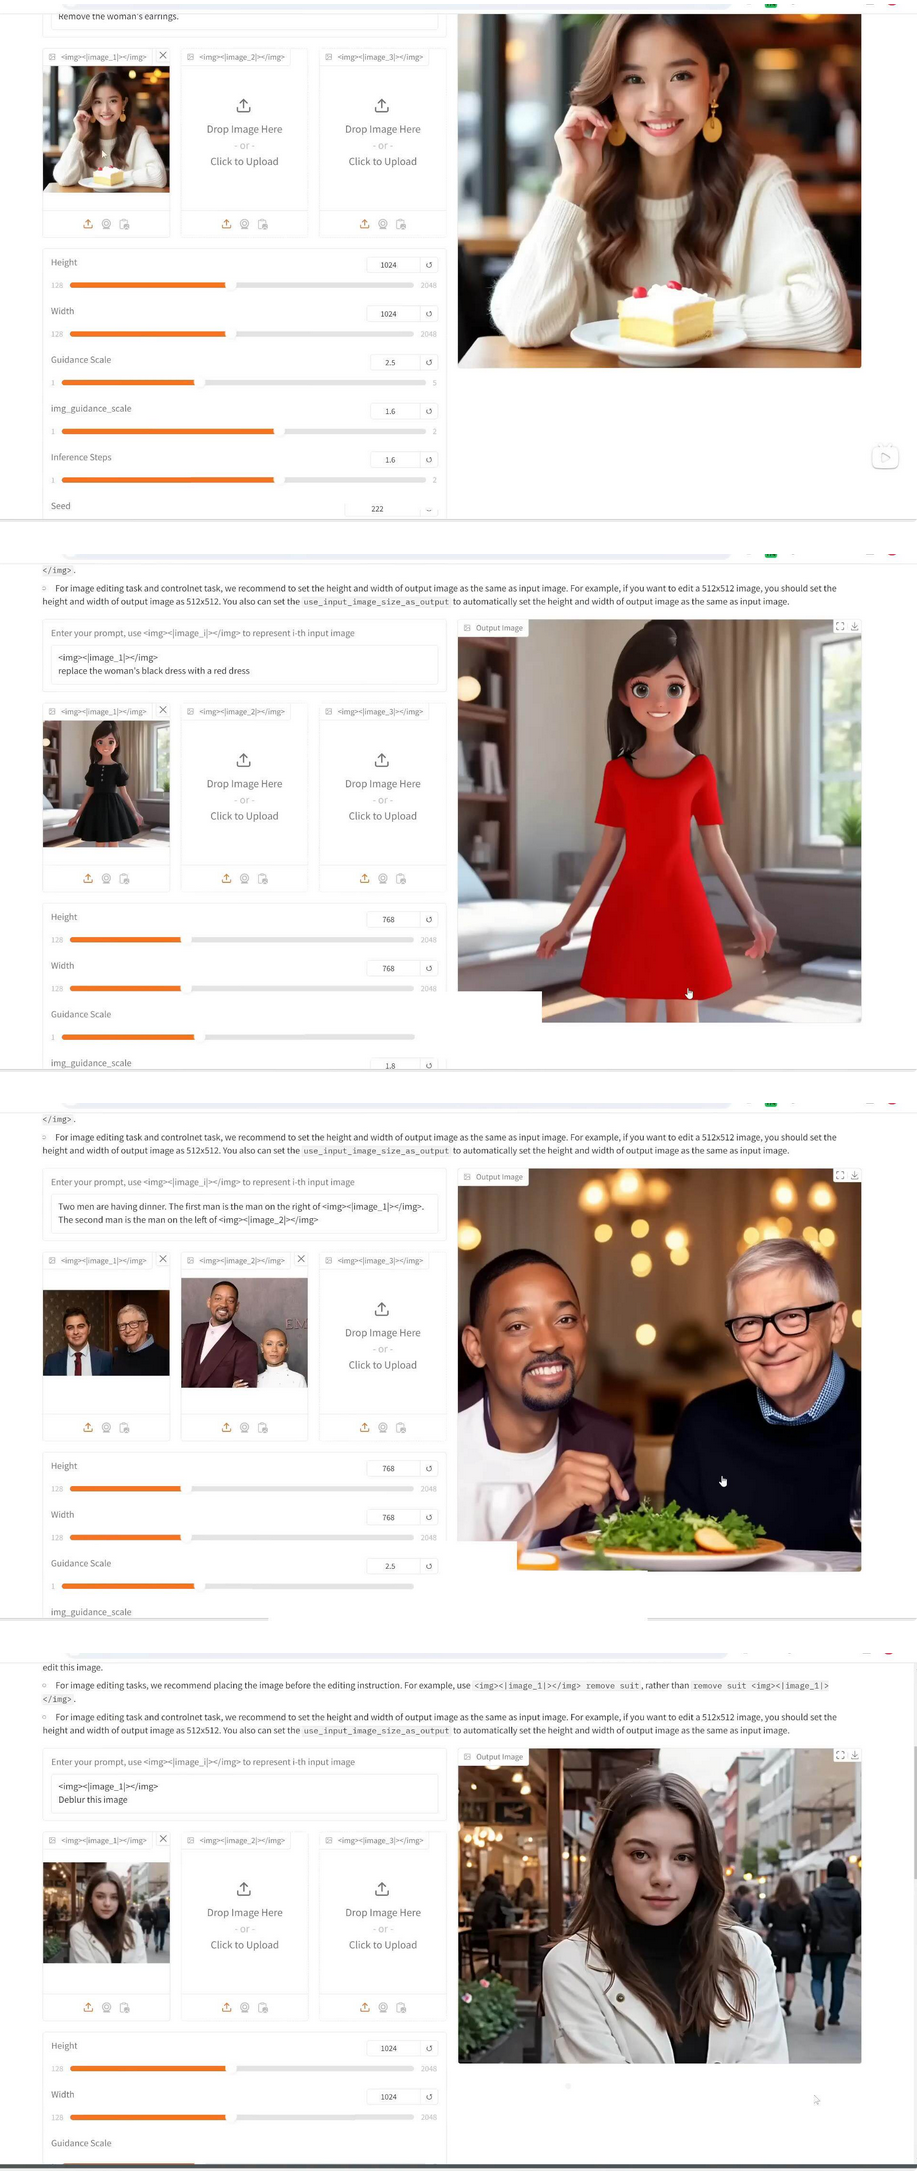
1. 1.统一性:QmniGen不仅能够执行文本到图像的生成,还内在支持多种下游任务,包括图像编辑、主题驱动生成和视觉条件生成。此外,OmniGen还能通过将它们转化为图像生成任务来处理一些经典计算机视觉任务,如边缘检测和人体姿态识别。
2. 2.简洁性:OmniGen的架构高度简化,消除了对额外文本编码器的需求,使得与现有扩散模型相比更加用户友好。它能够通过指令完成复杂任务,无需额外的预处理步骤,显著简化了图像生成的工作流程。
3. 3.知识迁移:得益于在统一格式中的学习,OmniGen能够有效地在不同任务之间转移知识,处理未见任务和领域,并展现出新的能力。
同时OmniGen团队还探索了模型的推理能力和链式思考机制的潜在应用,这是对通用图像生成模型的首次尝试。总之,OmniGen能够实现灵活和可控的图像生成,包括从文本生成图像、编辑生成图像的部分、基于生成图像中的人体姿态生成重绘,以及从另一图像中提取所需对象并整合到新图像中。它还能处理常见的图像生成任务和一些经典计算机视觉四任务,如去模糊、去雨、修复以及人物姿态图和深度图。OmniGen展现了潜在的推理能力和一定程度的上下文学习能力,框架通过模仿人类逐步绘画的过程,迭代细化图像,从而处理更复杂和多样化的场景。此外,OmniGen的设计原则是通用性和简洁性,避免了过于复杂的结构设计和众多额外组件。为了实现强大的多任务处理能力,OmniGen训练了一个大规模和多样化的数据集,称为X21数据集,包含约0.1亿张图像。
OmniGen一键整合包人物一致性解决新方案AI图像编辑神器+视频教程 … … … …

評論(24)
感覺還行,玩起來蠻順的。
這玩意兒真的太貴了吧。
我之前也卡過顯存不足的問題。
好像不需要額外的ControlNet,省事。
說真的,對我來說學習曲線還行。
哇,畫面細節竟然這麼清晰 😂
看起來像是把好幾個模型打包了。
這套整合包要是配上12G顯卡,速度會不會更快?
我在用16G內存跑,偶爾會卡,但總體還能接受。
剛看完官方教學,感覺流程簡化很多,但對於新手來說,還是需要多點實驗才能掌握細節,期待有更多範例。
真的好用,省了好多時間。
又是新神器,又要掏錢。
這套需要什麼版本的CUDA才能跑?
其實只要8G顯存也能跑,只是速度慢點。
我之前試過低配機,真的很卡。
說明文件太簡略,找不到細節。
感覺操作挺流暢的,沒卡。
如果只想做文字到圖像,真的還需要整合包才能完整功能嗎?
X21資料集規模大,訓練時耗資源不少,建議先測試小樣本。
我用16G內存跑過,偶爾卡頓但結果還是比單模型好不少。
這玩意兒真是太貴了,普通玩家根本負擔不起,感覺被高階玩家壟斷了,市場只剩少數人能玩。
看熱鬧,等結果。
省了安裝ControlNet的麻煩。
畫質超讚,值得入手 😊